
xAI เปิดตัว Grok 4.7 โมเดล AI รุ่นใหม่ ชูความสามารถด้าน Coding, Agent และงานความรู้ที่ต้องใช้เวลาประมวลผลยาวนาน พร้อมปรับปรุงการตรวจสอบคำตอบของตัวเองและการจัดการบริบทยาว ขณะที่ราคา API เริ่มต้นยังอยู่ที่ 2 ดอลลาร์ต่อ 1 ล้าน Input Tokens และ 6 ดอลลาร์ต่อ 1 ล้าน Output Tokens
xAI เปิดตัว Grok 4.7 เมื่อวันที่ 21 กันยายน 2026 โดยระบุว่าเป็นโมเดลที่มีความสามารถสูงสุดของบริษัทสำหรับงานเขียนโค้ดและงานความรู้ในขณะนี้ การอัปเกรดครั้งนี้มุ่งไปที่งานซับซ้อนที่ต้องทำหลายขั้นตอนและใช้เวลานาน มากกว่าการเน้นเพียงการตอบคำถามแบบทั่วไป
จุดเปลี่ยนสำคัญของ Grok 4.7 คือการออกแบบให้สามารถ ทำงานกับโจทย์ยากได้นานขึ้น ตรวจสอบผลงานของตัวเองได้ละเอียดขึ้น และจัดการบริบทที่ยาวกว่าเดิม โดย xAI ระบุว่าโมเดลใช้ Base Model รุ่นใหม่ที่มีขนาดใหญ่ขึ้นเมื่อเทียบกับ Grok 4.6 และผ่านการฝึก Reinforcement Learning ที่ยาวนานขึ้น โดยให้น้ำหนักกับโจทย์ที่ต้องใช้เวลาหลายชั่วโมงในการแก้ปัญหา
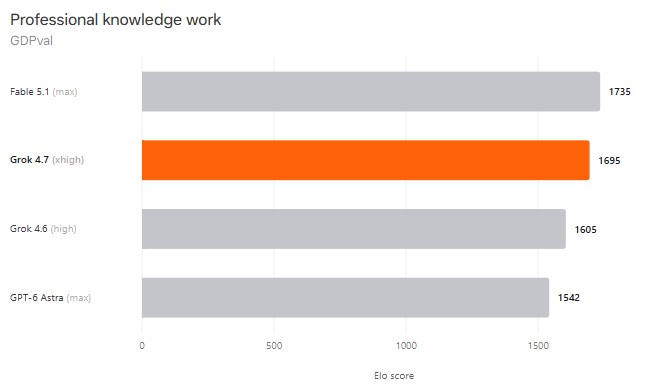
นอกจากนี้ xAI ยังฝึก Grok 4.7 ให้เข้าใจ Grok Bot harness ได้โดยตรง ซึ่งบริษัทระบุว่าช่วยเพิ่มความสามารถในการทำงานแบบสนทนา งานความรู้ทั่วไป รวมถึงการสร้างเอกสารและงานนำเสนอ ทำให้โมเดลไม่ได้ถูกวางตำแหน่งเฉพาะสำหรับนักพัฒนา แต่ยังรองรับงานสำนักงานและงานวิชาชีพที่ต้องทำเป็นขั้นตอนต่อเนื่องด้วย
Coding และ Agent คือสนามหลักของ Grok 4.7
ด้านการเขียนโปรแกรม xAI เปิดเผยว่า Grok 4.7 ทำคะแนน 46.3% ใน CursorBench 4.0 เพิ่มขึ้นจาก 40.4% ใน Grok 4.6 ขณะที่ Terminal-Bench 4.0 อยู่ที่ 38.0% เพิ่มขึ้นอย่างมากจาก 20.3% ในรุ่นก่อนหน้า โดยทั้งสองการทดสอบมุ่งวัดความสามารถในการทำงานด้านซอฟต์แวร์ที่มีหลายขั้นตอนและต้องดำเนินงานต่อเนื่อง
ส่วน DeepSWE v1.1 Grok 4.7 ทำได้ 71.0% ในการตั้งค่า High effort เทียบกับ 65.2% ของ Grok 4.6 ตามตัวเลขที่ xAI เผยแพร่ ซึ่งสะท้อนว่าบริษัทกำลังผลักโมเดลเข้าสู่การเป็นเครื่องมือสำหรับงาน Software Engineering ที่ต้องใช้การให้เหตุผลหลายขั้นตอนมากขึ้น
นอกเหนือจาก Coding แล้ว xAI ยังรายงานการปรับปรุงในงานวิชาชีพหลายประเภท เช่น AA Briefcase v1.1 สำหรับงานสำนักงานหลายชั่วโมง, Harvey Legal Agent Benchmark สำหรับงานด้านกฎหมาย, HealthBench Professional สำหรับการให้เหตุผลด้านสุขภาพ และ EEBench สำหรับงานวิศวกรรมไฟฟ้า โดยคะแนนของ Grok 4.7 สูงกว่า Grok 4.6 ในชุดทดสอบที่บริษัทนำเสนอทั้งหมด
ตัวอย่างเช่น EEBench เพิ่มจาก 53.0% ใน Grok 4.6 เป็น 64.0% ใน Grok 4.7 ส่วน Harvey Legal Agent Benchmark เพิ่มจาก 15.8% เป็น 19.6% และ HealthBench Professional เพิ่มจาก 48.5% เป็น 56.7%
อย่างไรก็ตาม ตัวเลข Benchmark เหล่านี้เป็นผลการทดสอบที่ xAI เผยแพร่เอง จึงควรพิจารณาร่วมกับผลการทดสอบจากแหล่งอิสระและรายละเอียดของวิธีประเมินแต่ละชุด ก่อนนำไปสรุปว่าโมเดลใดเหมาะกับงานประเภทใดมากที่สุด
รองรับบริบท 500,000 โทเคน
ในด้านเทคนิค Grok 4.7 รองรับ Context Window สูงสุด 500,000 โทเคน และรับทั้งข้อความและภาพเป็น Input ขณะที่ Output เป็นข้อความ โดยระบบรองรับระดับการใช้เหตุผล 4 ระดับ ได้แก่ Low, Medium, High และ xhigh ซึ่งค่าเริ่มต้นของ API คือ High
การมีบริบทขนาดใหญ่ช่วยให้โมเดลสามารถทำงานกับข้อมูลจำนวนมากภายในคำขอเดียว เช่น โค้ดขนาดใหญ่ เอกสารหลายชุด หรือข้อมูลที่เกี่ยวข้องกับงานระยะยาว โดยไม่จำเป็นต้องแบ่งข้อมูลออกเป็นส่วนเล็ก ๆ มากเท่ากับโมเดลที่มี Context Window ต่ำกว่า
อีกความสามารถที่น่าสนใจคือ Function Calling และ Structured Outputs ซึ่งเปิดทางให้ Grok 4.7 เชื่อมต่อกับเครื่องมือหรือระบบภายนอก และส่งผลลัพธ์ในรูปแบบที่กำหนดไว้ได้ เหมาะกับการพัฒนา AI Agent ที่ต้องเรียกใช้เครื่องมือและดำเนินงานหลายขั้นตอน
ราคา API ยังเท่าเดิม แต่มีเงื่อนไขเรื่อง Context
สำหรับนักพัฒนา xAI ตั้งราคา Grok 4.7 เริ่มต้นที่ 2 ดอลลาร์ต่อ 1 ล้าน Input Tokens และ 6 ดอลลาร์ต่อ 1 ล้าน Output Tokens ขณะที่ Cached Input Tokens อยู่ที่ 0.50 ดอลลาร์ต่อ 1 ล้านโทเคน สำหรับคำขอที่อยู่ภายใต้ 200,000 โทเคน
หาก Prompt มีขนาดเกิน 200,000 โทเคน จะเข้าสู่อัตราราคาที่สูงขึ้น โดยเอกสารของ xAI ระบุราคาเป็น 4 ดอลลาร์ต่อ 1 ล้าน Input Tokens, 1 ดอลลาร์ต่อ 1 ล้าน Cached Input Tokens และ 12 ดอลลาร์ต่อ 1 ล้าน Output Tokens สำหรับระดับดังกล่าว
ดังนั้น แม้ราคาเริ่มต้นของ Grok 4.7 จะเท่ากับ Grok 4.6 แต่ต้นทุนจริงต่อหนึ่งงานยังขึ้นอยู่กับจำนวนโทเคนที่ใช้ ระดับการใช้เหตุผล และขนาดของบริบทที่ส่งเข้าโมเดล
นอกจากนี้ xAI ยังมี Grok 4.7 Fast ซึ่งเป็นโมเดลเดียวกันที่ให้ความเร็ว Output สูงขึ้นประมาณ 2 เท่า แต่คิดค่าบริการในอัตรา 2 เท่าของรุ่นมาตรฐาน โดยขณะนี้ให้บริการผ่าน Cursor และ Grok Build และไม่ได้เปิดเป็นรุ่นแยกสำหรับ Public xAI API
มุ่งสู่ AI ที่ “ทำงาน” มากกว่าแค่ตอบคำถาม
อีกส่วนที่ xAI ให้ความสำคัญกับ Grok 4.7 คือระบบความปลอดภัย บริษัทระบุว่าได้สร้าง safeguard stack ชุดใหม่ และทดสอบทั้งความสามารถในการปฏิเสธคำขอที่เป็นอันตรายและความสามารถในการทำงานด้านความปลอดภัยไซเบอร์ที่ถูกต้องตามวัตถุประสงค์ โดย xAI รายงานว่าโมเดลทำคะแนนด้านความปลอดภัยดีขึ้นจากรุ่นก่อนในชุดทดสอบที่บริษัทใช้
Grok 4.7 เปิดให้ใช้งานแล้วผ่าน Grok API, Grok Build, Cursor รวมถึง coding harnesses และ model routers บางราย โดยใน API ใช้ชื่อโมเดล grok-4.7 และรองรับการเรียกใช้งานผ่าน Responses API และ Chat Completions
การเปิดตัวครั้งนี้สะท้อนทิศทางของ xAI ที่กำลังขยับ Grok จากผู้ช่วย AI สำหรับการสนทนา ไปสู่โมเดลที่สามารถรับผิดชอบ งานหลายขั้นตอน งาน Coding และงานแบบ Agent ที่ต้องวางแผน ลงมือทำ ตรวจสอบ และแก้ไขงานต่อเนื่อง มากขึ้น โดยยังรักษาราคา API เริ่มต้นในระดับเดียวกับ Grok 4.6
สำหรับผู้ใช้ทั่วไป ความแตกต่างอาจไม่ได้อยู่ที่การตอบคำถามสั้น ๆ เพียงอย่างเดียว แต่จะเห็นได้ชัดขึ้นเมื่อมอบหมายงานที่มีความซับซ้อนและต้องทำต่อเนื่องเป็นเวลานาน ซึ่งเป็นสนามแข่งขันสำคัญของโมเดล AI รุ่นใหม่ในปี 2026